International Conference on Knowledge and Systems Engineering(KSE 2026)採択論文のお知らせ
2026.11.04
このたび、Teeradaj Racharak 准教授 および Watanee Jearanaiwongkul 助教 が共著した以下の論文が、第18回 International Conference on Knowledge and Systems Engineering(KSE 2026) に採択されました。本会議は、2026年11月11日から14日 に 石川県金沢市 にて開催されます。KSEは、知識工学およびシステム工学の研究・開発・応用に関する最新の成果を発表・議論する国際会議です。
採択論文
Teeradaj Racharak, Mulati Renati, Watanee Jearanaiwongkul, Shinobu Hasegawa,
Explainable AI for Video Classification: Extending Intrinsically Interpretable Image Models to Facial Expression Recognition
In Proceedings of the 18th International Conference on Knowledge and Systems Engineering (KSE 2026), Kanazawa, Japan, November 11–14, 2026.
動画分類は、感情コンピューティング(affective computing)をはじめとする人間中心の応用分野で広く利用されつつあり、モデルには高い精度だけでなく、判断の根拠を説明できる透明性も求められています。しかし、既存の動画説明手法の多くは、各フレームに事後的な顕著性(saliency)手法を個別に適用するため、フレーム間で説明が不安定になりやすいという課題がありました。
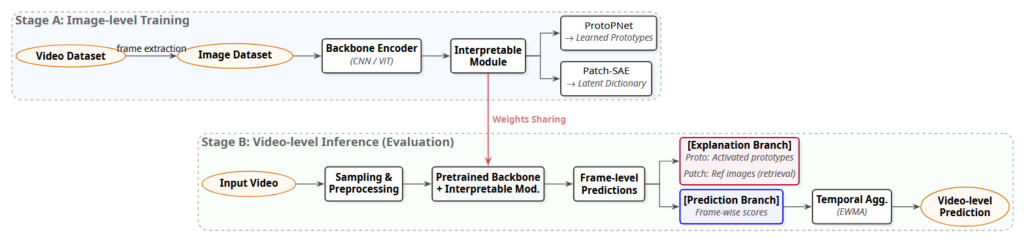
本論文では、動画理解を「本質的に解釈可能な画像レベルの推論器」と「軽量な時間方向の集約」に分離する統一的な枠組みを提案しています。各フレームで解釈可能な推論と説明を行い、指数加重移動平均(EWMA)によって予測を安定化させることで、ブラックボックス的な時間モデルを用いずに動画全体の判断を導きます。この枠組みのもとで、プロトタイプに基づくProtoPNetと辞書学習に基づくPatchSAEという二つの解釈可能なモデルを比較しました。表情認識データセットRAVDESSなどを用いた実験により、画像レベルの解釈可能モデルが動画にも効果的に適用できること、ProtoPNetは安定した顔の部位に基づく説明を与え、PatchSAEは体や手の動きにより適応しやすいことが示されました。
本研究は、ブラックボックスな動画モデルに代わる透明性の高いアプローチを示すとともに、説明可能な動画理解のためのベースラインを提供するものです。
著者の皆様のご活躍を心よりお祝い申し上げます。